

Anthropic于周二发布Claude Fable 5.1与Claude Mythos 5.1,这是自6月9日Fable 5推出以来Mythos级模型线的首次更新。公司宣称新模型是“全球最先进的编码与知识工作模型”,其在关键基准测试中的表现较前身翻倍。
此次发布处于一个长达三个月的发布周期中,该周期已包含18天的出口管制停摆、仲夏关于订阅权限的定价之争,以及7月发布的Claude Opus 5(其价格低于Fable 5)。
Myriad:OpenAI何时发布GPT-6?点击进行预测。
Fable 5.1与Mythos 5.1据Anthropic称是相同底层模型加上不同的安全过滤器。Fable 5.1对任何Claude账户普遍可用。Mythos 5.1仍限制于通过Anthropic网络验证计划和生命科学验证计划(Project Glasswing访问跟踪的继任者,该跟踪限制了Mythos 5)审核的网络安全和生命科学专业人员。
基准实际衡量什么
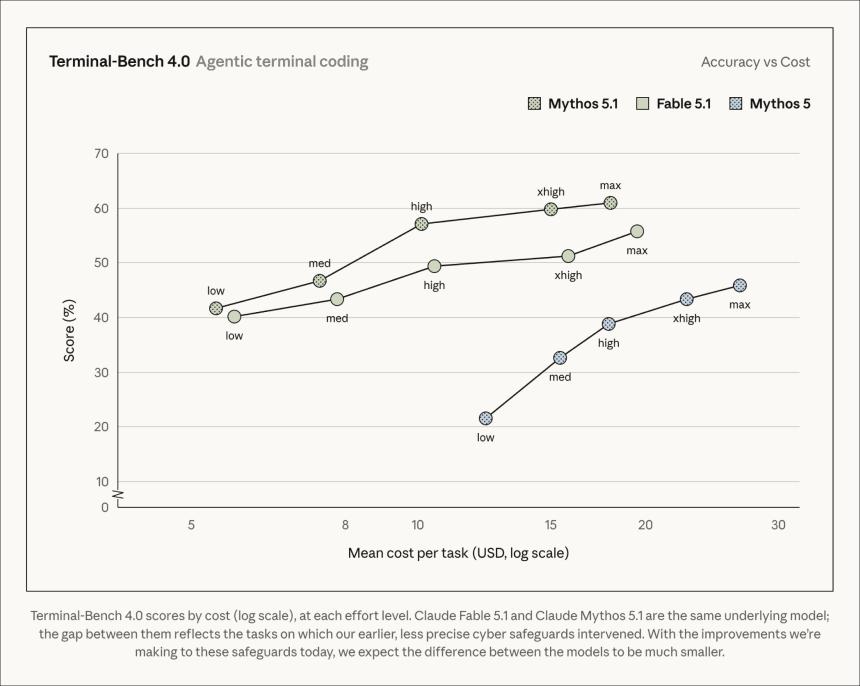
Anthropic的头条数字来自Terminal-Bench-Science 0.1,该基准测试AI代理是否能在命令行环境中执行科学研究任务,以通过率计分。Fable 5.1获得52.6%,对比Fable 5的24.7%和Opus 5的29.0%,超过前代两倍。Terminal-Bench 4.0测试通过终端完成的代理编码——在多学科命令行会话中编写、运行和调试代码,以正确完成任务百分比计分。Fable 5.1得分55.8%,高于Fable 5的42.0%和Opus 5的52.3%。Mythos 5.1运行较轻的网络安全过滤器,在同一测试中得分60.9%;Anthropic说差距反映了其安全措施拦截并重新路由到Opus 4.8的任务。
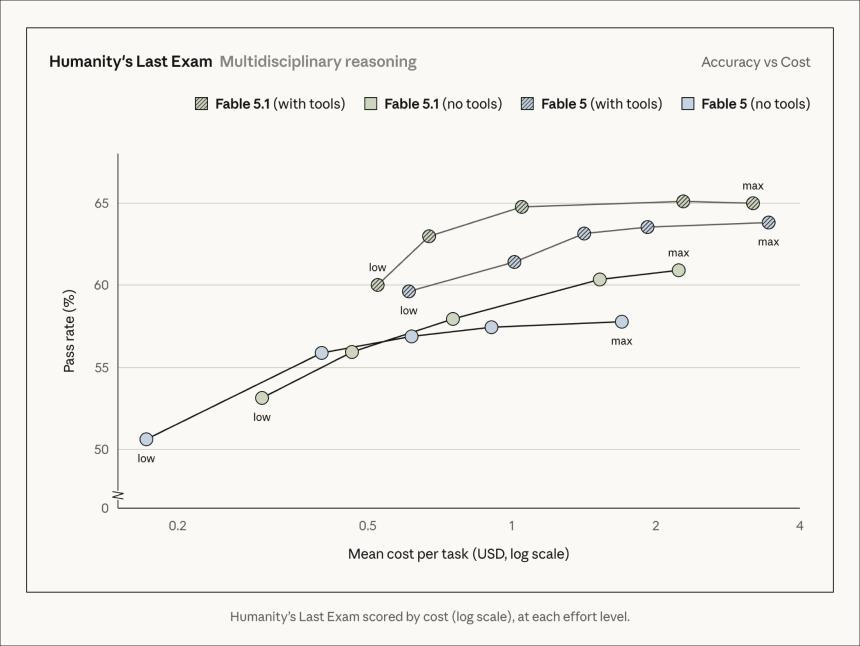
在Humanity's Last Exam(一个由数十个学术领域的专家级问题构建的多学科推理测试,以通过率计分)中,Fable 5.1无外部工具达到60.9%,有工具达到65.0%,均领先Opus 5,显示这是Anthropic最先进的学术用途模型。
何处击败Opus 5,何处数学变模糊
Opus 5于7月发布,成本仅为Fable 5每令牌价格的一半,同时在大多数主要基准上得分超过Fable 5,实质上使旗舰模型对大多数付费用户冗余。Fable 5.1逆转了这一点:现在它在Anthropic发布的所有基准上击败Opus 5,包括之前Opus 5击败Fable 5的那些。但Fable 5.1每令牌成本仍是Opus 5的两倍——输入$10输出$50对比Opus 5的$5和$25。令牌是模型能处理的基本信息量(通常约平均英文单词的三分之二),公司按使用付费,因为繁重工作流通常很快耗尽订阅计划中的配额。
Anthropic对该模型的推销依赖于努力水平而非原始分数:它表示以低或中等推理努力运行Fable 5.1匹配或击败Fable 5的旧结果且成本更低,同时保留最高努力层级用于难住其他一切的问题。对于常规工作,随着努力旋钮调低,完全跳过Opus 5的理由变弱。
访问权限遵循适用于Fable 5的相同拆分(经过Anthropic数月调整条款)。在Pro计划以及标准Team或Enterprise席位上,Fable 5.1完全来自按使用量计费的使用积分,按API费率计费,因为它不属于那些计划的每周限制。在Max计划以及高级Team或Enterprise席位上,它作为订阅的标准部分包含,最多占每周使用量的50%。Claude Fable 5.1现已在Claude API、Amazon Bedrock、Google Cloud和Microsoft Foundry上可用,模型ID为“claude-fable-5-1”。